Claude Code mit Ollama: was „lokal" wirklich heißt
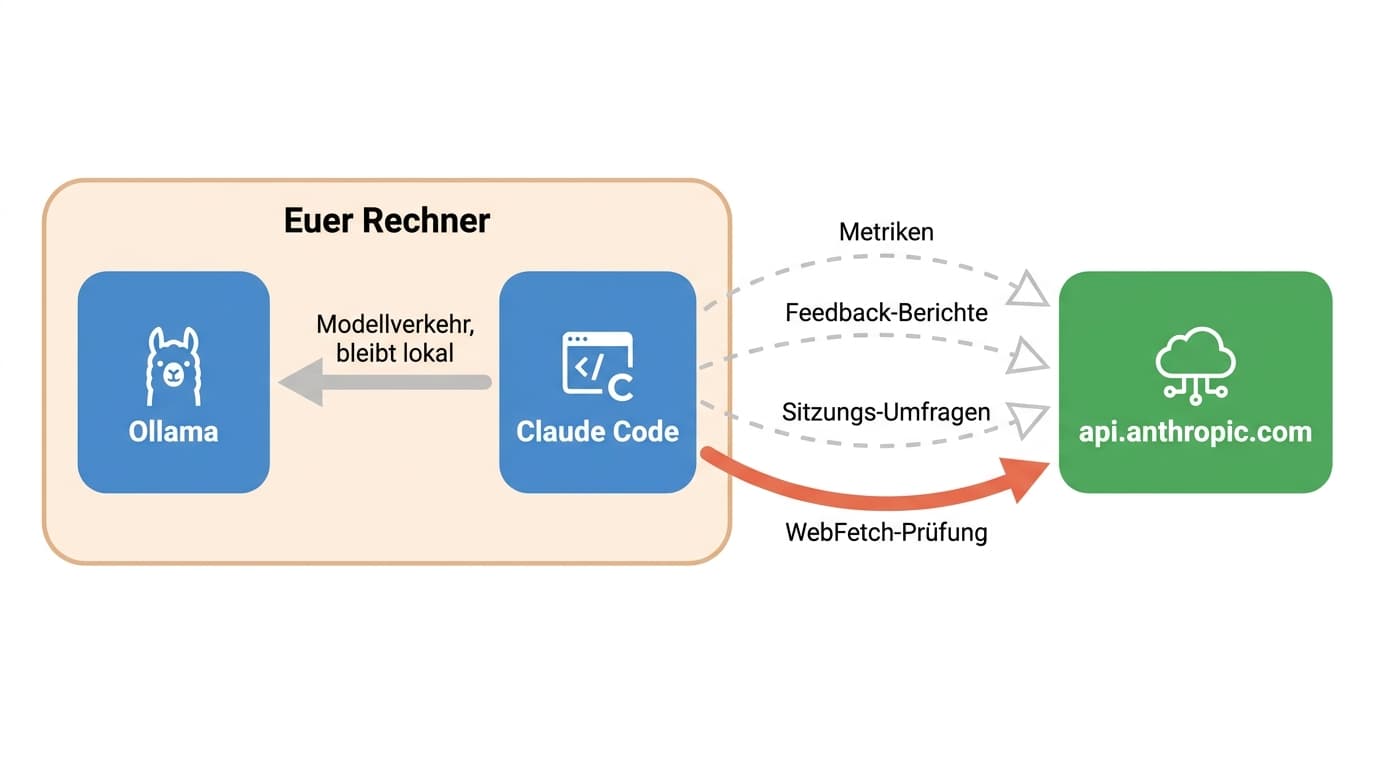
Claude Code lässt sich über drei Umgebungsvariablen auf einen lokalen Ollama-Server umbiegen, statt auf die Anthropic-API zuzugreifen. Die Modellanfragen bleiben dann tatsächlich auf dem eigenen Rechner. Vier weitere Verbindungen zu Anthropic bleiben aber standardmäßig offen, und eine davon lässt sich nicht über den Sammelschalter abschalten. Dieser Beitrag zeigt das Setup, benennt die vier Kanäle, rechnet die Hardware gegen das Abo (Break-even nach gut 40 Monaten) und erklärt, warum die offizielle Kontextempfehlung genau dort anfängt, wo lokale Modelle nachlassen.
Es gibt eine Sorte Anleitung, die im Moment sehr gut funktioniert: „Claude Code kostenlos und lokal mit Ollama". Wir haben für diesen Beitrag die fünf Artikel gelesen, die dazu gerade oben stehen, zusammen rund 13.000 Wörter, dazu die offizielle Ollama-Dokumentation. Alle sechs beschreiben dasselbe Setup, und alle sechs versprechen dieselben zwei Dinge: es kostet nichts, und der Code verlässt nie euren Rechner.
Das Setup stimmt. Die beiden Versprechen stimmen so nicht. Nicht, weil jemand lügt, sondern weil in keinem der sechs Texte jemand nachgesehen hat, was Claude Code selbst noch sendet, wenn man es auf einen lokalen Server zeigen lässt, und weil keiner die zweite Hälfte der Kostenrechnung aufmacht. Dieser Beitrag holt beides nach und benennt zusätzlich einen Widerspruch zwischen den Anleitungen, der darüber entscheidet, ob das Ganze an einem echten Projekt überhaupt läuft.
Das Setup, kurz gefasst
Claude Code spricht mit einem Endpunkt, der die Anthropic-Messages-API versteht. Ollama bringt diese Kompatibilität mittlerweile mit. Deshalb genügt es, drei Umgebungsvariablen zu setzen, damit die Anfragen nicht mehr zu Anthropic gehen, sondern an den lokalen Server auf Port 11434.
ANTHROPIC_BASE_URL zeigt auf den lokalen Ollama-Server statt auf die Anthropic-API.
ANTHROPIC_AUTH_TOKEN bekommt einen Platzhalterwert, weil ein lokaler Server keinen echten Schlüssel prüft.
ANTHROPIC_API_KEY wird geleert, damit kein hinterlegter Schlüssel den Platzhalter überstimmt.
Danach startet man Claude Code mit einem lokal vorhandenen Modell. Wer den Weg über die Cloud-Modelle kennt, findet die Einrichtung in Claude Code installieren beschrieben; was das Werkzeug überhaupt tut, steht in Was ist Claude Code. Der Rest dieses Beitrags setzt beides voraus, weil das Setup der unstrittige Teil ist. Interessant wird es danach.
Ein Punkt vorweg, der oft untergeht und den nur eine der gelesenen Quellen deutlich sagt: Sie bekommen dabei nicht Claude. Sie bekommen die Bedienoberfläche und die Werkzeuglogik von Claude Code, angetrieben von einem völlig anderen, offenen Modell. Die Intelligenz kommt vom Modell, nicht vom Rahmen. Wer das verwechselt, erklärt sich später die Ergebnisse falsch.
Was trotzdem noch nach außen geht
Hier liegt der eigentliche Grund für diesen Beitrag. Das Datenschutz-Argument ist in allen sechs Quellen das Hauptargument, und in keiner wird es zu Ende geführt. Wir haben deshalb nicht die Anleitungen zitiert, sondern die Betreiberdokumentation von Claude Code selbst gelesen, und zwar den Abschnitt zu Telemetrie und Standardverhalten je Anbieter.
Der entscheidende Punkt ist unscheinbar: Wenn Sie nur ANTHROPIC_BASE_URL umbiegen, ändert das für Claude Code nicht den Anbieter. Aus seiner Sicht sprechen Sie weiterhin mit der Claude API, sie steht nur woanders. Und in der Spalte „Claude API" stehen die Nebenkanäle auf „standardmäßig an". Wer dagegen offiziell auf einen anderen Anbieter wechselt, etwa Bedrock oder Foundry, bekommt sie automatisch abgeschaltet. Der lokale Weg über Ollama fällt in die schlechtere der beiden Kategorien, und niemand weist darauf hin.
Vier Kanäle bleiben offen. Drei davon lassen sich abschalten, der vierte nicht mit demselben Schalter:
Kanal
Was geht raus
Abschaltbar
Nutzungsmetriken
Laufzeit, Zuverlässigkeit, Nutzungsmuster. Kein Code, keine Prompts, keine Dateipfade.
Ja, DISABLE_TELEMETRY=1
Feedback-Berichte
Nur auf Ihren Befehl, dann aber mit Gesprächsverlauf einschließlich Code.
Ja, DISABLE_FEEDBACK_COMMAND=1
Sitzungs-Umfragen
Die Bewertung selbst. Die Rückfrage nach dem Transkript schickt erst auf ausdrückliche Zustimmung etwas.
Ja, CLAUDE_CODE_DISABLE_FEEDBACK_SURVEY=1
WebFetch-Domainprüfung
Der angefragte Hostname geht vor jedem Abruf an Anthropic, gegen eine Sperrliste. Nur der Hostname, nicht Pfad oder Inhalt.
Nicht über den Sammelschalter. Nur über die Einstellung skipWebFetchPreflight
Der Sammelschalter CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC deckt die ersten drei ab. Die WebFetch-Prüfung nimmt die Dokumentation ausdrücklich davon aus: Sie läuft unabhängig vom gewählten Anbieter, und wer sie abstellt, ruft URLs künftig ohne Abgleich gegen die Sperrliste ab. Das ist eine bewusste Abwägung, aber eben eine, die man treffen muss und nicht geschenkt bekommt.
Nichts davon ist ein Skandal. Metriken enthalten keinen Code, Feedback geht nur auf Befehl, und beim Hostnamen geht es um eine Sicherheitsprüfung. Der Punkt ist ein anderer: Wenn Sie diesen Aufbau wählen, weil eine interne Vorgabe „kein Code und keine Metadaten zu Dritten" verlangt, dann ist die Voreinstellung nicht das, was Sie brauchen. „Lokal" ist hier ein Ergebnis, das man herstellen muss, kein Zustand, den das Setup mitliefert.
Die Rechnung, die niemand aufmacht
Das zweite Versprechen lautet „kostenlos". Alle gelesenen Quellen rechnen dafür die Cloud-Seite vor und keine die lokale. Eine beziffert den Einstieg in Claude Code sogar mit 100 Dollar im Monat, dem Max-Tarif. Das ist schlicht falsch: Claude Code ist laut Anbieter bereits in Claude Pro für 20 Dollar im Monat enthalten, im Jahresabo für 17. Die Cloud-Seite wird dort also um das Fünffache überzeichnet, und der Vergleich fällt entsprechend deutlich aus.
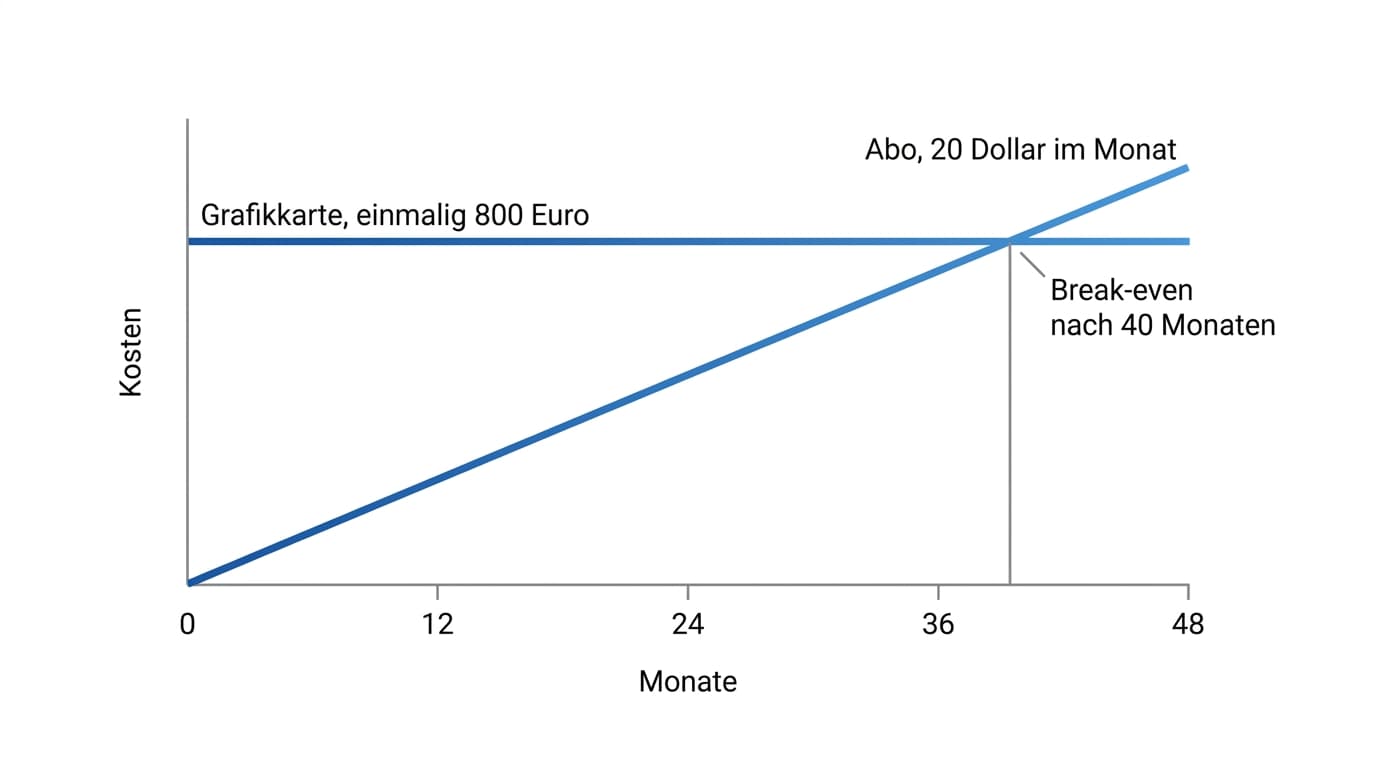
Die lokale Seite ist nicht kostenlos, sie ist nur vorbezahlt. Die Anleitungen nennen für brauchbare Ergebnisse 16 bis 24 GB Grafikspeicher. Die günstigste ernstzunehmende Karte in dieser Klasse ist derzeit eine gebrauchte RTX 3090 mit 24 GB, die im September 2026 zwischen 800 und 950 Euro gehandelt wird. Rechnet man das gegen ein Pro-Abo, ergibt sich ein unbequemes Bild.
Selbst wenn man Euro und Dollar der Einfachheit halber gleich ansetzt, dauert es über 40 Monate, bis sich die Karte gegen ein Pro-Abo gerechnet hat. Über dreieinhalb Jahre. In dieser Rechnung fehlen noch der Strom, der Rechner drumherum und die Zeit für Einrichtung und Pflege. Wer die Cloud-Seite mit dem 100-Dollar-Tarif ansetzt, kommt auf acht Monate, und genau dieser Wechsel der Bezugsgröße macht in den Anleitungen den Unterschied zwischen „lohnt sich sofort" und „lohnt sich vielleicht nie".
Das ist kein Argument gegen den lokalen Betrieb. Es ist ein Argument dagegen, ihn mit dem Preis zu begründen. Wer Hardware ohnehin im Haus hat, etwa einen Arbeitsplatzrechner mit passender Karte oder einen Server, für den die Rechnung anders aussieht, kommt zu einem anderen Ergebnis. Wer eine Karte kauft, um zu sparen, spart nicht. Die ausführliche Aufstellung der Cloud-Tarife steht in Claude Code Kosten.
Was die Maschine leisten muss
Auch bei der Hardware widersprechen sich die Quellen, und zwar erheblich. Eine der großen Anleitungen nennt 16 bis 24 GB Grafikspeicher als Anforderung und empfiehlt konkrete Karten der Oberklasse. Eine andere führt eine Spanne von 4 bis über 32 GB, gestaffelt nach Quantisierungsstufe, und kritisiert dabei ausdrücklich die kleingerechneten Mindestangaben der Konkurrenz. Beide haben recht, sie reden nur über verschiedene Dinge: Die kleine Zahl beschreibt, ab wann das Modell lädt. Die große beschreibt, ab wann die Arbeit damit Spaß macht.
Für die Praxis sind drei Größen entscheidend, und keine davon ist die Modellwahl:
Größe
Was die Quellen nennen
Warum es zählt
Grafikspeicher
4 bis über 32 GB je nach Quantisierung, 16 bis 24 GB für komfortables Arbeiten
Passt das Modell nicht hinein, weicht es auf den Hauptprozessor aus. Es läuft dann noch, aber deutlich langsamer.
Ausgabegeschwindigkeit
10 bis 40 Token pro Sekunde, je nach Aufbau
Bei agentischer Arbeit summiert sich das über viele Schritte. Die Untergrenze dieser Spanne ist der Unterschied zwischen Werkzeug und Geduldsprobe.
Plattenplatz
ab 25 GB frei, ein einzelnes mittleres Modell wiegt rund 13 GB
Wer mehrere Modelle vergleichen will, was am Anfang der Normalfall ist, braucht ein Vielfaches davon.
Die ehrlichste Zahl in allen gelesenen Quellen steht in einem Nebensatz: Ein gängiges offenes Modell dieser Klasse erreicht auf einem verbreiteten Qualitätsindex einen Wert von 39, während die großen Cloud-Modelle über 60 liegen. Das ist kein kleiner Abstand, und es ist die Zahl, die man beim Wort „kostenlos" mitdenken sollte. Man bezahlt nicht mit Geld, sondern mit Ergebnisqualität und mit der eigenen Zeit für Nacharbeit.
Der Widerspruch, der über die Praxistauglichkeit entscheidet
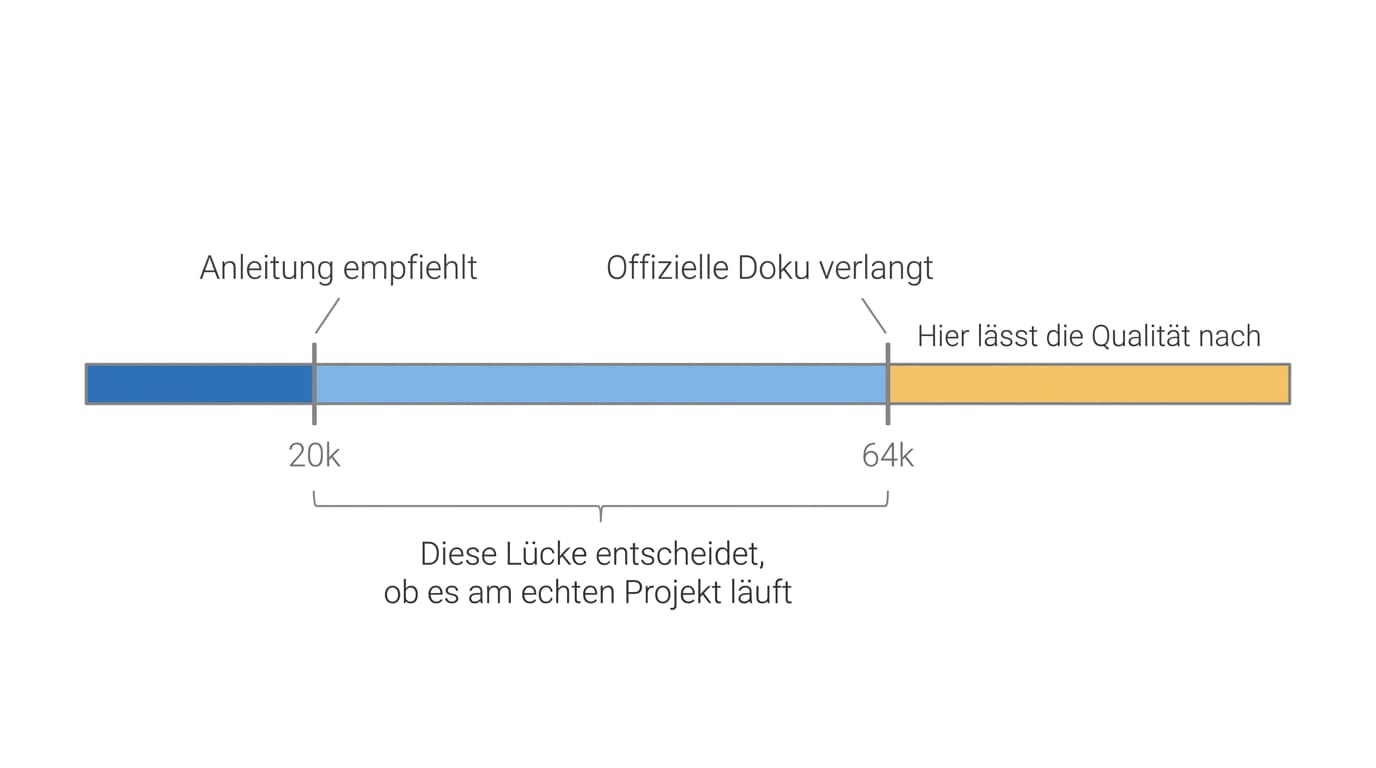
Beim Kontextfenster widersprechen sich die Quellen, und keine erwähnt es. Die offizielle Ollama-Dokumentation schreibt für größere Repositories 64k oder mehr vor. Eine der meistgelesenen Anleitungen führt im Setup-Schritt 20k als Empfehlung. Und die gründlichste der deutschsprachigen Quellen setzt genau bei 64k den Punkt an, ab dem lokale Modelle in der Kontexttreue nachlassen.
Legt man die drei Angaben nebeneinander, entsteht eine enge Zange. Unterhalb von 64k reicht der Kontext für ein echtes Projekt nach offizieller Aussage nicht, oberhalb davon lässt die Qualität der Modelle nach. Wer mit den empfohlenen 20k startet, baut sich das Ergebnis vorweg: Am Beispielprojekt aus dem Tutorial läuft es, am eigenen Repository verliert das Modell den Faden, und man hält das für ein Modellproblem, obwohl es eine Konfiguration war.
Dazu kommt ein Verhalten, das nur eine Quelle beschreibt und das in der Praxis am meisten stört: Werkzeugschleifen. Das Modell ruft dieselben Werkzeuge wiederholt auf, ohne voranzukommen. Bei agentischer Arbeit über viele Dateien ist das der häufigste Abbruchgrund, und er tritt bei kleineren offenen Modellen deutlich öfter auf als bei den großen Cloud-Modellen. Wer die Werkzeuganbindung selbst schon einmal gebaut hat, kennt das Muster aus Claude Code und MCP.
Wann sich der lokale Weg lohnt
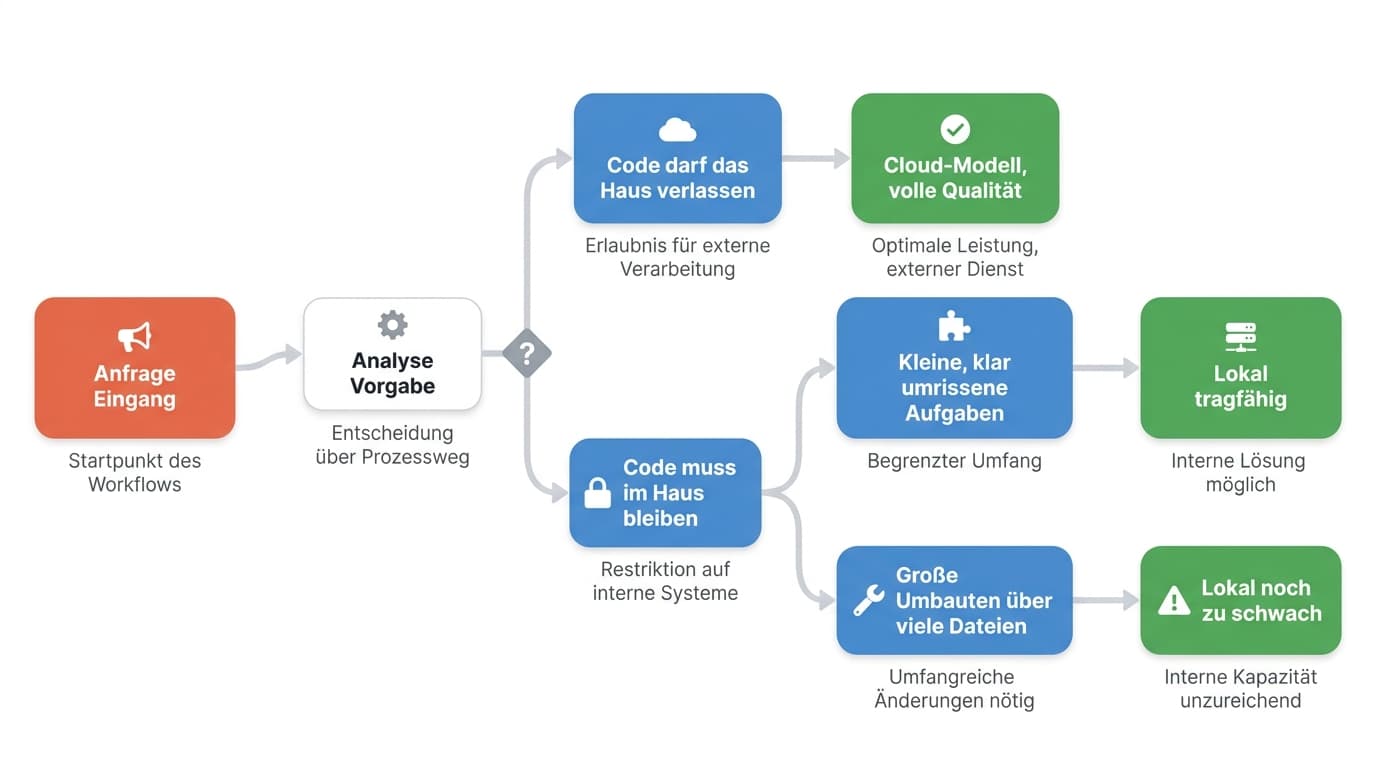
Nach allem oben bleibt eine klare Aufteilung. Der lokale Betrieb ist kein Sparmodell und keine allgemeine Alternative. Er ist die richtige Antwort auf genau eine Frage: Was tun, wenn der Code das Haus nicht verlassen darf.
Diese Frage stellt sich in unserer Arbeit regelmäßig, und zwar nicht als Vorliebe, sondern als Berufsrecht. Für Kanzleien hängt sie an § 43e BRAO, für Steuerberater an § 62a StBerG: Wer Mandantendaten an einen Dienstleister gibt, braucht dafür eine tragfähige Grundlage. Verlässt der Code den Rechner gar nicht erst, stellt sich die Frage in dieser Form nicht mehr, und genau deshalb ist der Aufbau interessant. Wie wir das jenseits des Coding-Falls umsetzen, steht unter Private AI für Kanzleien und Private AI für Steuerberater.
Nur bleibt die Einschränkung aus dem vorigen Abschnitt bestehen, und sie ist der Grund, warum wir den lokalen Weg selten allein empfehlen: Für abgegrenzte Aufgaben trägt er, für große Umbauten über viele Dateien reichen die offenen Modelle in dieser Größenklasse noch nicht. In der Praxis heißt das meistens zwei Wege nebeneinander, getrennt nach Datenart statt nach Aufgabe. Sensibles bleibt lokal, der Rest läuft über die Cloud-Modelle, wo die Qualität stimmt. Für einen ersten Eindruck, wie sich das gegen andere Werkzeuge verhält, hilft Claude Code vs. Codex.
Fazit
Claude Code auf Ollama umzustellen ist in fünf Minuten erledigt und technisch unspektakulär. Was danach gilt, ist es nicht. Die Modellanfragen bleiben lokal, vier Nebenkanäle stehen aber voreingestellt offen, und einer davon lässt sich nicht mit dem Sammelschalter zudrehen. Die Ersparnis stellt sich erst nach über drei Jahren ein, wenn man die Hardware ehrlich mitrechnet. Und die Kontextempfehlung, die für ein echtes Projekt nötig ist, beginnt genau dort, wo die Modelle nachlassen.
Das macht den Aufbau nicht schlechter, es macht ihn nur spezifischer. Er ist gut, wenn die Vorgabe lautet, dass Daten das Haus nicht verlassen. Er ist schwach, wenn er nur billiger sein soll. Wenn Sie überlegen, ob das für Ihre Situation trägt, oder wenn Sie eine Vorgabe im Haus haben, an der die Cloud-Werkzeuge scheitern, sprecht uns an.
Häufig gestellte Fragen
Hier finden Sie die Antworten auf häufig gestellte Fragen.
Kann ich Claude Code mit Ollama benutzen?
Ja. Ollama versteht inzwischen die Anthropic-Messages-API, deshalb genügt es, Claude Code über drei Umgebungsvariablen auf den lokalen Server umzubiegen: ANTHROPIC_BASE_URL zeigt auf den lokalen Ollama-Port, ANTHROPIC_AUTH_TOKEN bekommt einen Platzhalter, und ANTHROPIC_API_KEY wird geleert, damit kein hinterlegter Schlüssel den Platzhalter überstimmt. Danach starten Sie Claude Code mit einem lokal geladenen Modell. Sie bekommen dabei nicht Claude, sondern die Oberfläche und Werkzeuglogik von Claude Code auf einem offenen Modell.
Bleibt mein Code wirklich komplett auf meinem Rechner?
Die Modellanfragen ja, der Rest nicht automatisch. Wenn Sie nur ANTHROPIC_BASE_URL umbiegen, gilt für Claude Code weiterhin die Voreinstellung des Anbieters Claude API, und dort stehen Nutzungsmetriken, Feedback-Berichte und Sitzungs-Umfragen auf an. Die Metriken enthalten laut Dokumentation keinen Code und keine Dateipfade, Feedback geht nur auf ausdrücklichen Befehl. Zusätzlich schickt die WebFetch-Prüfung vor jedem Seitenabruf den angefragten Hostnamen an Anthropic, und dieser Kanal wird vom Sammelschalter CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC ausdrücklich nicht erfasst.
Ist Claude Code mit Ollama wirklich kostenlos?
Die Software ja, der Betrieb nicht. Für brauchbare Ergebnisse nennen die Anleitungen 16 bis 24 GB Grafikspeicher; eine gebrauchte Karte mit 24 GB kostet im September 2026 zwischen 800 und 950 Euro. Claude Code ist dagegen bereits in Claude Pro für 20 Dollar im Monat enthalten. Selbst bei einer Eins-zu-eins-Umrechnung dauert es über 40 Monate, bis sich die Hardware gerechnet hat, Strom und Einrichtungsaufwand noch nicht eingerechnet. Wer passende Hardware ohnehin besitzt, rechnet anders; wer sie zum Sparen kauft, spart nicht.
Welches Kontextfenster brauche ich für ein echtes Projekt?
Die offizielle Ollama-Dokumentation nennt für größere Repositories 64k oder mehr. Verbreitete Tutorials empfehlen im Setup dagegen 20k, was am Beispielprojekt reicht und am eigenen Repository nicht. Gleichzeitig setzen erfahrene Quellen genau bei 64k den Punkt an, ab dem lokale Modelle in der Kontexttreue nachlassen. Praktisch heißt das: unterhalb von 64k fehlt der Überblick, oberhalb leidet die Genauigkeit. Wer mit 20k startet, hält später eine Fehlkonfiguration für ein Modellproblem.
Welche Modelle eignen sich für Claude Code über Ollama?
Die Quellen nennen durchgehend auf Code spezialisierte offene Modelle, dazu allgemeine Modelle in verschiedenen Quantisierungsstufen. Wichtiger als die Modellwahl sind zwei andere Größen: ein ausreichend gesetztes Kontextfenster und genug Grafikspeicher, damit das Modell nicht auf die CPU ausweichen muss, was die Ausgabe deutlich verlangsamt. Rechnen Sie außerdem mit Werkzeugschleifen, bei denen das Modell dieselben Aufrufe wiederholt, ohne voranzukommen. Das ist bei kleineren offenen Modellen der häufigste Abbruchgrund.
Für wen lohnt sich der lokale Betrieb überhaupt?
Für alle, bei denen eine Vorgabe verlangt, dass Daten das Haus nicht verlassen. Für Kanzleien und Steuerberater ist das kein Geschmacksurteil, sondern Berufsrecht nach § 43e BRAO beziehungsweise § 62a StBerG. Verlässt der Code den Rechner nicht, stellt sich die Frage der Weitergabe an einen Dienstleister in dieser Form nicht. Als reines Sparmodell lohnt er sich dagegen selten, und für große Umbauten über viele Dateien reichen die offenen Modelle dieser Größenklasse noch nicht. In der Praxis laufen deshalb meistens beide Wege nebeneinander, getrennt nach Datenart.